リコーは、大規模言語モデル(LLM)からの有害情報の出力を検知するガードレール機能を組み込んだ「セーフガードモデル」を開発したと発表した。従来の有害なプロンプト入力の判別に加え、LLMが生成する有害情報の出力の検知にも対応することで、多層的な安全対策を実現する。
アンソロピック、評価額141兆円でOpenAI超えへ──人類史上最大の資金調達ラウンド(Forbes JAPAN) - Yahoo!ニュース
カバー株式会社、例のラプラス・ダークネスさんの投稿について経緯を説明
漢検公式アカウントがAI生成を使う→誤字に気付かず発信してしまう「誤字というか存在しない漢字?」「公式として一番やったらあかんミスやな」
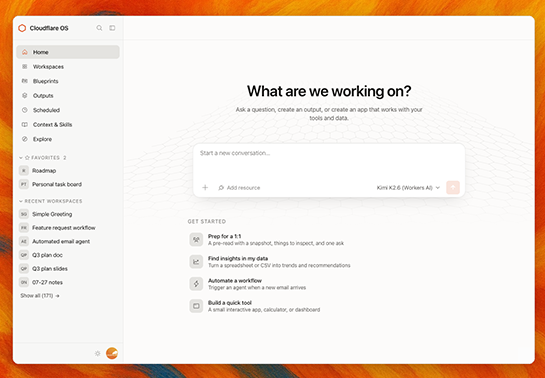
「Cloudflare OS」のマネージドサービス提供へ。GitHubとの接続やGmailとの連携強化など
OpenAIのmisalignment reportsを読む:「GETだけ許可」の社内モデルはどう制限を越え、どう見つかったか
まだコメントはありません。
コメントを送信しました。
 AIニュース